Greg Brockman, az OpenAI vezetője elismerte, hogy a ChatGPT szó szerint képes befejezni a NYT-cikkekből származó mondatokat
Röviden: Az emberi kihalással vagy egy hatalmas pénzügyi buborékkal kapcsolatos aggodalmak mellett a generatív mesterséges intelligencia egyik legnagyobb vitája az, hogy a technológiai óriások hogyan képezik ki modelljeiket. Míg az OpenAI és a Microsoft azt állítja, hogy a szerzői joggal védett anyagokon végzett mesterséges intelligencia képzése méltányos használat alá tartozik, a vállalatok belső megjegyzései ennek ellenkezőjét sugallhatják.
A csütörtökön nyilvánosságra hozott bírósági dokumentumok szerint Brent Hecht, a Microsoft alkalmazott tudományos igazgatója azt jósolta, hogy az emberek világszerte soha nem látott mértékű lopásnak tekintik a nagy nyelvi modelleket. Úgy tűnik, hogy a megjegyzések ellensúlyozzák a Microsoft és az OpenAI nyilvános védekezését a hírügynökségek által indított perrel szemben.
Az ügy legfrissebb bejelentésében Hecht szerint a generatív mesterséges intelligencia az emberiség történetének legnagyobb munkalopása lehet, miközben leírja, hogy a Microsoft, az OpenAI és más mesterségesintelligencia-vállalatok hogyan képezik modelljeit a nyílt internetről származó hatalmas mennyiségű anyagon. Ez a gyakorlat áll a The New York Times által 2023 végén benyújtott szerzői jogi per középpontjában.
A Microsoft és az OpenAI azzal érvel, hogy a mesterséges intelligencia modellek képzése a NYT-ből és más kiadványokból származó cikkeken a méltányos használat alá tartozik, hasonlóan a könyveket olvasó diákhoz. Az alperesek azt is állítják, hogy az e cikkeken alapuló generatív mesterséges intelligencia-kimenet kellőképpen átalakítja az eredeti anyagot.
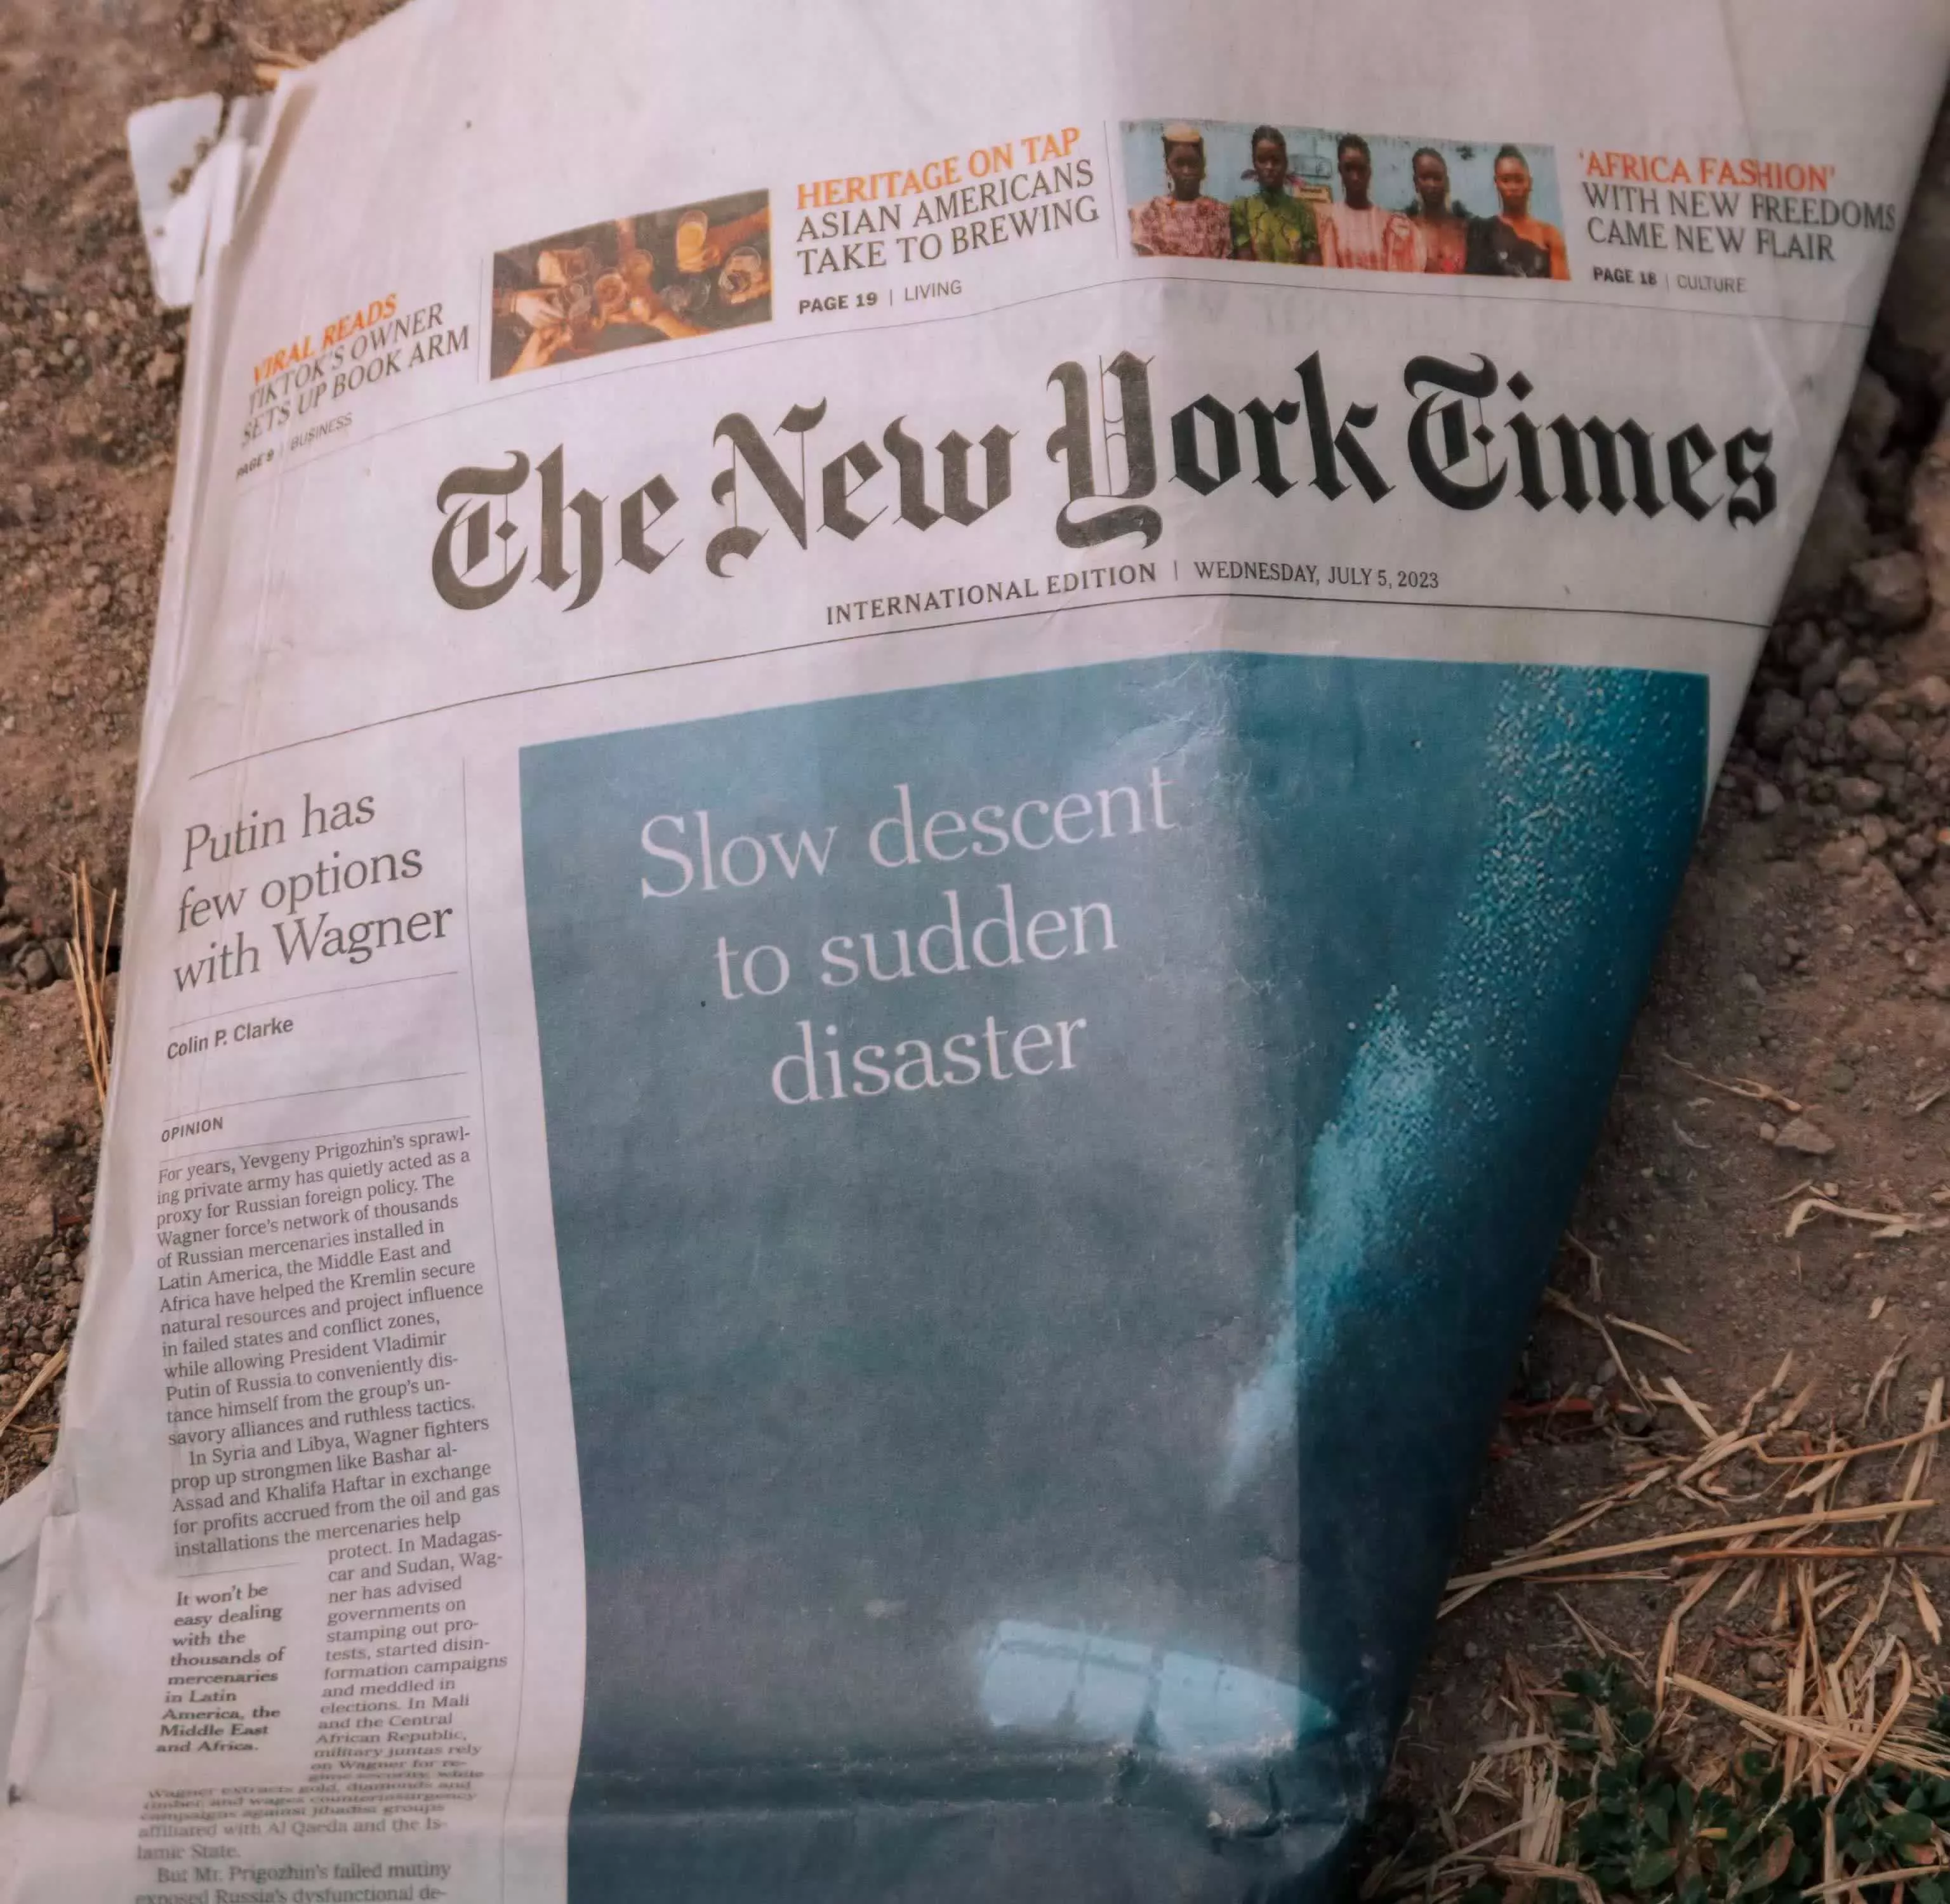
A csütörtöki bejelentés azonban az OpenAI belső megjegyzéseit tartalmazza, amelyek kiemelik az AI hírcikkek reprodukálására való képességét. Greg Brockman, az OpenAI vezetője például elismerte, hogy a ChatGPT képes megjósolni és kiegészíteni a NYT-cikkek mondatait, amikor az üzlet anyagával dolgozik. Hecht azzal is érvelt, hogy a per megnyerése megkövetelheti a vádlottaktól, hogy „teljesen kigúnyolják a méltányos használat gondolatát”.
Az OpenAI korábban azt is elismerte, hogy a mesterséges intelligencia képzése a szerzői jog által védett anyagokhoz való hozzáférés nélkül lehetetlen. A Meta korábbi vezetője, Nick Clegg tavaly is ezt a nézetet hangoztatta, és azt állította, hogy a mesterséges intelligencia szinte azonnal meghalna, ha a szerzői jogi törvényt érvényesítenék ellene.
Eközben az AI-cégek folytatták modelljeik képzését felhasználói adatokkal, cikkekkel és egyéb anyagokkal. A Meta vitákat váltott ki a mesterséges intelligencia képzése miatt az alkalmazottak viselkedésére, a Microsoft GitHub Copilotja a felhasználói adatokra oktat, hacsak a felhasználók nem iratkoznak fel, a Twitch pedig csak azután kezdte lehetővé tenni, hogy a streamerek leiratkozhassanak, miután évekig tanultak az anyagukon. A mesterséges intelligencia fejlesztői csendesen vásárolnak, szkennelnek és semmisítenek meg több millió könyvet, hogy további oktatási anyagokat gyűjtsenek össze.
A generatív AI hatása a hírek üzleti modelljére a NYT perének másik pillére. A Google és más keresőmotorok mostantól mesterséges intelligencia által generált összefoglalókat adnak a cikkekből, válaszul a felhasználók kérdéseire, ezzel potenciálisan elriasztják az olvasókat a híroldalak látogatásától. Az e heti bírósági beadványban az OpenAI egyik vezetője, aki részt vett a ChatGPT fejlesztésében, azt mondta, hogy a kiadók az AI egzisztenciális fenyegetésével néznek szembe.